个人智能体是未来,自主软件是路径
像 OpenAI Dots 这样的个人智能体是正确的长期目标,但现在不是好时机。本文认为应该先构建自主软件(Agentic Software),并说明 Sign in with ChatGPT 与 Claude Mods 如何帮助我们走向这一步。
省流:个人智能体(Personal Agents)是正确的长期目标,但现在并不是做这个的好时候。今天最该做的是构建自主软件(Agentic Software):自带原生智能体的应用。这类软件是目前拓展 Agentic AI 能力更有效的方法,也是个人智能体未来立足的地基。所以我觉得 Sign in with ChatGPT 和 Claude Mods 是本周影响更加长远的发布。
本周因为包含了本年度的 OpenAI Dev Day,所以又是非常激情的一周。9 月 29 日,OpenAI 在 DevDay 2026 上发布了 Dots。每个 Dot 都是一个全天候运行的智能体,拥有自己的云端计算机。你给它一个目标、连接你的应用,它就在后台工作,把完成的结果交给你审批。Dots 形态的 Personal Agent 最近确实挺火的。Meta 在 9 月 8 日发布了 Muse,在北美一度风头非常大,顺带着把 Meta 和藤子的股票都加了一把火。微软在 9 月 25 日扩展了 Copilot Autopilot,Perplexity 在 9 月 29 日推出了 Computer Automations(Orthotropy)。每一家大实验室都想成做个人智能体。
不过虽然个人智能体(Personal Agents)在当下非常获得非常大的关注,而且我也觉得这在将来会是非常大的应用市场,也是很正确的产品形态,Dots 的产品设计思路也总体上是对的,但是我依然觉得现在这个时间点是非常不好的时间。在错误的时间发布的产品也只能是错误的产品,感觉发展会类似于 OpenClaw,在明年这个时候就变得基本上无人问津了。
而同一周,还有两项发布我觉得才会是对整个行业产生更加深远影响的设计:Sign in with ChatGPT 和 Claude Mods。我认为,对整个 Agentic AI 生态来说,这两个才会是更加重要的部分,当然我也会说明我觉得他们做的不足的地方。
一、为什么个人智能体前景广阔
智能体(包括未来的个人智能体)会改变了我们使用计算机的方式。今天,我们与计算机、软件和互联网交互的时候更多的时候用户是主动一方,在个人智能体的语境之下,用户给智能体的是泛化目标,或者说是一种预期,智能体在整个过程中会成为更加主动的一方。
我们可以先抛开各种限制与约束,如果先让我们来设计一个个人智能体,我们应该如何设计?
那么最核心的:
- 这个智能体肯定是一个 Y 型智能体,不仅是 24/7 的智能体,同时还是一个完全基于你的智能体。因为这个智能体必须长时间自持,同时不停的更新与用户相关的记忆,并且不断发现哪些是用户独特的记忆,同时通过连接器链接所有用户日常会花时间的产品。
- 同时,这个智能体肯定要使用足够强大的基础模型,甚至要远强于它应该去解决的问题,因为它不仅要去解决问题,还要去发现问题,也就是说智能体去处理的问题空间是一个比比用户面临的日常问题空间大的多的多的空间,所以一定要使用非常强的模型,即使是强到一般用户觉得很浪费。
那么,Dots 展示了这在实践中的样子:
- 它是持续存在的。 Dot 在对话之间持续工作,并从你的反馈中学习。
- 它有自己的计算机。 它在云端运行 GPT-6 Astra,配有浏览器,可连接 4,000 多个应用。
- 你不在时它也在工作。 没有任务时,它会用只读工具做后台调研。
- 它就在你工作的地方。 你可以在 ChatGPT、Slack 和 Teams 中给它发消息或打电话,短信功能即将推出。
可以发现,Dots 就是一个很符合我们期望的设计,首先是一个长运行的智能体,同时可以加载所有的记忆,阅读所有的 ChatGPT 对话与工作,通过连接器链接邮箱、文档库、各种本地内容等,然后 Dots 使用了 Astra 作为基础模型,虽然有很多人觉得非常浪费,但这个才是正确的设计,如果要做个人智能体,就一定要去用最强的基础模型,才能符合个人智能体的预期。
发布时 OpenAI 展示了很多,其中一个例子很小但是很说明问题。一位早期测试者的 Dots 发现他忘了给一家刊物开发票。它根据日程记录与邮件准备好了发票,并在批准后发出(BGR)。
这才是真正的前景。聊天机器人在你提问时回答(我一直讲聊天机器人视为一种计算器级别的应用),而个人智能体会注意到有关于你的一切。对研究长程智能体(long-horizon agents)的人来说,这就是我们的研究问题变成了产品。所以,个人智能体是一个正确的产品形态,也是一个正确的需求,未来肯定会大放异彩的,只不过我觉得,现在就是一个错误的时间点。
二、为什么现在对于个人智能体可能还为时过早
个人智能体在现在的核心问题只有一个,就是个人智能体对于目前的产业来说,属于资源错配。也就是说,个人智能体为整个 Agentic AI 产业在当前这个时间点带来的促进作用远远小于个人智能体会花费的资源,特别是当前是一个算力紧张、需要将更多的资源用在拓展 Agentic AI 能力边界的时候。
完全形态的个人智能体理解为一个长期在线、真正了解你的一切、代表你持续行动的智能体,那么个人智能体对整个 Agentic Stack 的需求比普通智能体高太多。
首先,个人智能体的价值来自“长期”,而长期运行恰恰是今天智能体最薄弱的地方。它需要持久身份、长期记忆、持续执行和状态管理;可一旦时间尺度拉长到几天或几个月,记忆漂移、上下文污染、状态不一致和错误累积就会出现。我们目前最成熟的,仍然是按会话运行的智能体。为了解决这个问题,可能需要在后台付出非常多额外的静默运行,去持续进行状态与记忆管理,这就让个人智能体对算力的需求非常高。现在不太好评估如果一个用户更多的使用个人智能体能否降低这种偏移积累,如果可以的话或许这个问题还能解决。
其次,个人智能体某种程度上需要访问“我的一切”,而这意味着对连接器的生态提出非常大的要求,目前大部分大型服务都提供了连接器,但是其中的大部分连接器并不涉及核心操作,更多的是只读式的受限设计,所以目前各家依然使用 Computer Use 作为兜底策略,这种信息孤岛还需要更多的时间进行推动解决。或许将来的某一个时间点,数据确权运动完成,任何不能提供完全的连接器访问的服务都没有生存空间,到时候“我的一切”是自然而然可以连接的,但是至少现在依然无法做到这一点。
然后,即使是目前的访问范围,在个人智能体的容错率极低的前提下,个人智能体的操作安全与数据安全问题非常棘手。代码智能体犯错可以回滚,研究智能体犯错可以重跑,这些目前智能体进行后训练时看重的任务与个人智能体面临的情况区别非常大。个人智能体发错邮件、花错钱、泄露隐私等基本上是单向操作,很难有办法挽回。在这个场景下,即使是 95% 的成功率听起来很低,所以整个系统的可靠性需求其实是非常高的。
另一个要紧的事情就是成本问题,如果需要达到以上的预期很好的效果,目前只有力大飞砖一个方案,但是这个成本是很难从普通用户手里收到的。目前的智能以 token 计费,然而缺乏一种共识的等价对比方案。比如电,可以用度数来计费,但是一度电能做多少事情用户是有这个认知的,比如可以取暖多久呀、看电视多久呀、洗多少衣服呀之类的。即使是互联网,用流量计费,这些流量对应多少分钟电影电视剧、可以刷多久短视频、听多少音乐这些也是大致有认知的,然而目前用户对于多少 token 对应多少事情基本上是没有认知的,目前不同的基础模型与 Agent 行为差别很大,完全没有共识上的等价对比方案。
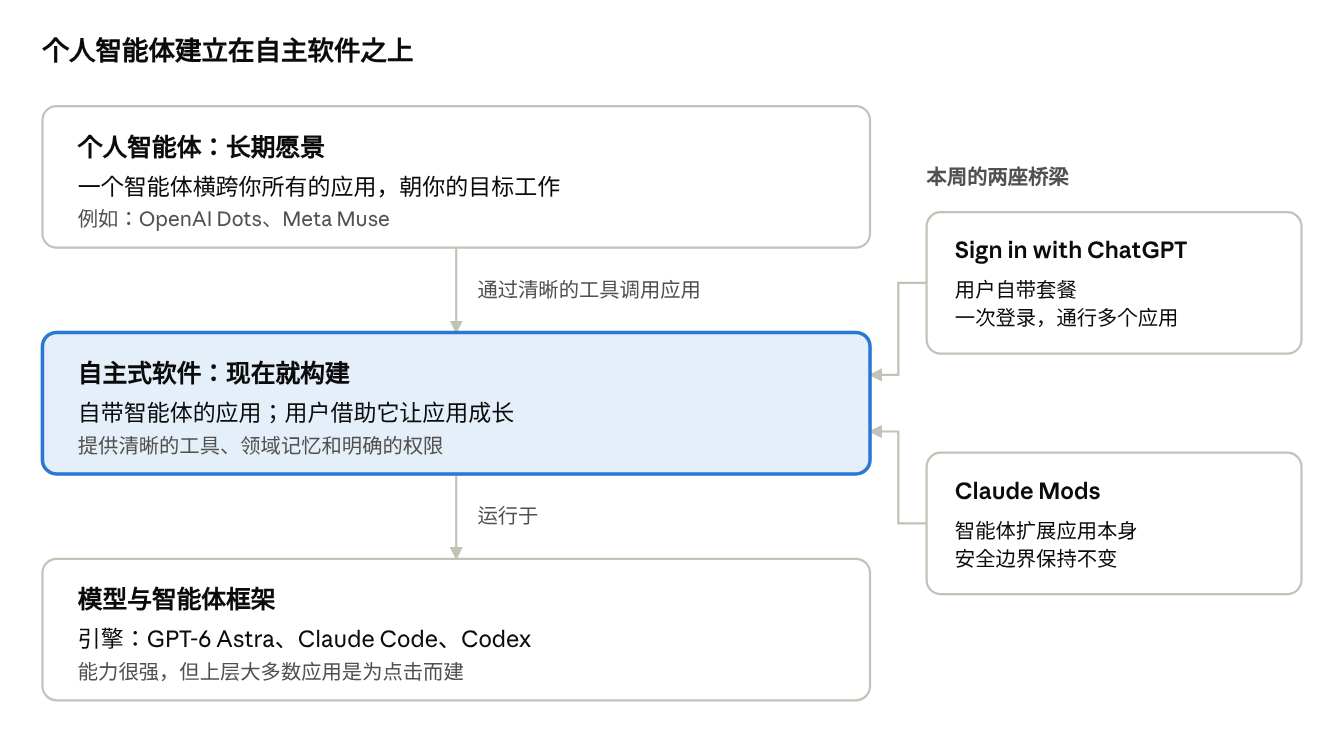
同时,今天还没有稳定的自主软件层。大多数软件仍是为人类点击界面设计的,缺少机器可读的状态、agent-native API、委托认证、事务回滚和事件订阅。依赖关系是:基础模型 → 智能体运行框架 → 自主软件 → 身份、委托与个人上下文 → 个人智能体。我们很容易直接跳到最上层,但下面几层还没有完成。
要让个人智能体真正可用,整个 Agentic Stack 的每一层都要到位。今天做个人智能体,大部分资源其实花在补齐下层的缺口上,而不是推动智能体能力的边界。具体来说,有六个缺口:
| 缺口 | 做个人智能体时,资源花在哪里 | 为什么现在补不上 |
|---|---|---|
| 1. 长期运行 | 记忆管理、状态一致性、错误恢复 | 最成熟的仍是按会话运行的智能体;时间拉长到几天、几个月,就会出现记忆漂移、上下文污染和错误累积 |
| 2. 个人上下文 | 连接器、OAuth、数据映射与同步 | 个人数据散落在几十个孤岛里,还没有统一的个人上下文层 |
| 3. 委托授权 | 细粒度权限、审计、撤销 | 现有权限体系是为“人 → 软件”设计的,不是“人 → 智能体 → 子智能体 → 服务” |
| 4. 容错 | 人工审批、事务、回滚 | 发错的邮件、花错的钱无法 revert;95% 的成功率放到每天几十个动作上,远远不够 |
| 5. 成本 | 24/ | 算力紧张;Dots 用 Astra 是对的设计,但正因如此,代价极高,还没计算后台静默对齐的费用 |
| 6. 自主软件层 | 用 computer use 去操作为人类点击设计的界面 | 大多数软件还没有 agent-native API、语义化操作和事件订阅 |
资源错配,而不是方向错误
这六个缺口有一个共同点:它们都是下层基础设施的问题,而不是上层智能的问题。个人智能体的瓶颈,正在从 intelligence 转向 systems reliability。
所以今天直接做一个“万能个人智能体”,大量工程工作其实是在重新实现身份认证、连接器、记忆、权限、浏览器自动化和可靠性设施,再加上 24/7 的前沿模型算力。这就是资源错配:投入很大,却很少推进 Agentic AI 的能力边界。
而且,个人智能体目前对于拓展 Agentic AI 能力边界意义不大,从个人智能体这个产品形态本身来说,最主要的检测指标其实是用户的体感指数,也就是个人智能体如何确定性的解决了用户的哪些确定的问题。然而,现在我认为更重要的是拓展 Agentic AI 能力边界,也就是把 Agent 引入更多不确定提供什么帮助的不确定性场景中,这与这个产品形态本身的指标是对应的。
话都说到这个份上了,这也是 to B 业务与 to C 业务的一个很大的区别,我一直认为,任何产业发展都是实验室阶段 -> 产业重构阶段 -> 个人普及阶段,也对应了我之前文章中提到的加法器,乘法器与指数器阶段。不管是电力、算力还是互联网,都是先落地实验室,推动实验室内的进步,然后小范围的应用,在这个技术上,去探索技术对于产业的升级作用,也就是首先驱动专用生产力的提高,为此会专门进行产业重构,也就是围绕着这个技术去重新设计以前的工业模式,最后才是个人的普及阶段,从而实现全社会的重构。具体的内容可以去看我以前的问题,专门详细的讨论了工业革命与技术爬坡之间的关系。
对于 Agent 来说,就分别对应了 X 型 / Y 型 / Z 型智能体。然而,我认为目前我们还在 X 型阶段往 Y 型去爬坡的时候,现在当务之急是拓展 Agentic AI 的边界,提高 Agent 的可靠性与可预期性,然后围绕着这个重构各种重要的产业链,比如软件产业、医药行业、化学化工等,然后才是考虑 Z 型智能体的事情。我之前的文章也涉及了这部分内容。
现在就是一个非常严重错配的阶段,至少我认为个人智能体不是现在这个阶段最应该解决的问题。
不过,我也认为“太早”并不等于“方向错”。个人智能体肯定是一个好的形态,既然都已经开始做了,我觉得我们也应该更多的考虑一下把自主软件是作为一个基础设施去建设。先把下面几层建好,个人智能体就可以更加从容搞的去自主理解整个数字世界,这样只需要成为一个代表个人持续行动的智能层。所以下一章讨论自主软件。
三、为什么现在应该构建自主软件(Agentic Software)
我所说的自主软件,是指原生携带智能体的应用。智能体是应用的一部分,在设计和制作软件的时候就在的成员,甚至就是在智能体的帮助之下完成了软件的构建,同时构建的软件本身也包含了一部分参与构建软件的智能体。而用户通过这个智能体,还可以继续持续构建和塑造这个应用。
我在之前的文章中也详细的介绍了 Agentic Software 的概念,在这个意义下,用户不仅是软件的使用者,也是软件的共建者。之后,用户还可以通过 Knowledge-based Pull Request 的形式,将知识发送到数字的软件中心,从而帮助到所有的用户,实现知识的数字中心化。
个人智能体是横向的:一个智能体,横跨你所有的应用。自主软件是纵向的:一个智能体,深入了解一个领域。两者我们都需要,但纵向这一层,今天就能做好。
个人智能体位于最上层。当下层的应用是智能体原生的,而不仅仅是可点击的、或者说是固定式的设计好的,个人智能体才能发挥最大作用。所以,自主式软件层就是现在最应该去做的产业层。
- 自主软件:范围小,信任才可能建立。 智能体的数据、工具和行为都有边界。用户能看到它在做什么,并及时纠正。
- 自主软件:应用变成用户自己的。 当用户能借助应用的智能体来扩展与改造软件,因为用户才是最贴近真实场景,在使用软件的人。每一份副本都会朝不同方向生长,软件不再是千人一面,而用户也成为软件的共建者。
- 自主软件:软件产业的升级。 软件可以分阶段提升,也不必等待完全自主。现存的软件可以首先使用智能体完成智能化说明书、用户引导与用户定制化 setting,这就能帮助用户更好的上手,而 record skill 与 automation 功能则可以快速将用户常用的标准化流程非常轻松的保存下来。我在文章“Agent 软件作为所有软件的基石”中详细的描述了整个过程。
- 自主软件:构建个人智能体所需要的东西。 每个智能体应用都提供清晰的工具、结构化知识、领域记忆和明确的权限。未来的个人智能体可以直接调用这些应用,而不必在界面上点来点去。
- 自主软件:拓展 Agentic AI 的边界。在所有的软件构建成为自主软件的过程中,也顺带将各种独特的、真实的业务场景完成详细的数字化与智能体化改造,从而甚至可以为基础模型的后训练提供更加多样、更加真实的智能边界场景,从而提高基础模型的 AGI 能力。
简而言之,个人智能体的上限,取决于它所使用的软件。自主软件,就是让这些软件准备好的方式。
四、统一的 OpenAI 登录与 Claude Mods 如何帮助我们构建
本周的两项发布,为自主软件清除了两大障碍。一个解决了“谁来付费、用户是谁”的问题;另一个展示了应用如何与它的智能体一起成长。
Sign in with ChatGPT:身份与算力
如果阅读完了上面的内容,很自然的就会想到如果用户也要参与共建,在这种情况下,人工智能就要成为一种类似于电力或者算力的基础设施。那么,本周推出的 Sign in with ChatGPT 我认为就是在 AI 成为基础设施,或者说一种生产要素非常重要的一步!我认为相比于 Dots,显然 Sign in with ChatGPT 才是更加重要的、具有更深远影响的发布。因为用户可以随时将自己的智能调用到更加广泛的范围内。
以前,智能体应用只有两个糟糕的选择:要么开发者为每一次模型调用付费,要么让用户粘贴自己的 API key。Sign in with ChatGPT 提供了第三种选择。用户用 ChatGPT 账号登录。Plus 和 Pro 用户可以用自己的套餐来支付你应用中的 AI 请求,这些请求计入他们套餐的用量(OpenAI 帮助中心)。这个设计很谨慎。用户可以为每个应用设置每周用量上限。应用只能拿到姓名、邮箱和头像,拿不到用户的对话、记忆或 API key。
这对小团队和开源项目最为重要。你可以发布一个内置真正智能体的应用,而不必承担推理成本。它也让用户在多个应用之间拥有同一个身份。这是迈向“智能体以同一个‘你’在应用之间穿梭”的第一步。
同时,我认为,在这种模式之下,软件与基础模型厂商也可以具有一个新的关系,甚至达成一种新的经济模式。我在以前的文章中也详细的解释了这一种模式。也就是,软件开发商不仅是基础模型厂商的用户(因为需要使用 coding agent 构建软件),也可以成为基础模型厂商的分销商。软件用户接入基础模型厂商的服务,并且因为一些功能消耗了用户的 token 时,软件厂商应该将其视为一种对智能服务的分销,从而获得其中的一部分收益。在这种情况之下,软件厂商会更加有动力将软件的所有环节都 agent 化,甚至达到 Agentic Software 的状态,而原本软件的用户也多了一种为软件厂商提供收入的途径,从而使得原本传统的软件厂商可以更好的融入到 Agent 时代。
所以,我认为 Sign in with ChatGPT 是很大的一步,这也是整个产业与社区往 Agentic Software 方向走的一步,我觉得其他的基础模型厂商很快也会跟进这一点。
Claude Mods:能自我扩展的软件
Claude Code 2.1.287 于 10 月 1 日推出了 Mods(mods)。一个 mod 是一个小型 JavaScript 或 TypeScript 插件。它挂接在 Claude Code 内部的事件上,比如一次工具调用、一条提示词,或界面的绘制。mod 可以观察事件、修改事件,或完全接管它。
关键在于:你可以让 Claude 给 Claude Code 自己添加功能。例子包括一个显示未提交改动的面板,以及显示上下文窗口使用情况的“Token Weather”(daily.dev)。这正是自主软件的模式:应用自带智能体,用户借助这个智能体让应用成长。Mods 也展示了风险。它们没有沙箱隔离。Anthropic 警告,mod “可以读取你的密钥……包括 API key”。但有一个设计选择值得注意:mod 可以重新设计大部分界面,却不能改动权限提示。安全边界始终在智能体够不到的地方。
类似的 idea 在之前的 DeepSeek Harness 中已经有一些展示,比如“一切皆插件”的理念,而 DeepSeek Harness 显然提供了更大的权限给用户用于改造应用的行为,甚至任何人都可以基于 DSH 的底子,重新搞一个自己的 Agent Application 出来,也可以随意的修改底层的行为。相比之下,Claude 的部分更加受限,约束更加严格,不过我觉得这反而是 Claude 设计的更好的部分,从这个角度出发,两者的设计出发点是完全不同的,只是在形式上可能有点类似,本质是不同的东西。不过,这些都可以视为 Agentic Software 的一种形式,用户根据自己的需要改造需要的部分,然后通过 Mods 市场或者插件市场的形式将这种改造发布到中心,从而更好的帮助到所有的人。
我觉得这些都是非常好的尝试,只不过目前不管是 Claude 还是 DeepSeek 在这部分的设计我认为都可以在设计上多做一步。目前的构建方案都没有明确的区分 Agent 指向的作用域,这种作用域不仅是实际上对于代码修改的作用域,还体现在开发者认知上的作用域。也就是说,我觉得现在 Agent 各种功能的设计,都应该提高可靠性与可预测性,其中一个非常重要的就是 Agent 的行为开发者和使用者应该有所预期。所以,从这一点上出发,Claude Mods 的设计就优于 DSH Plugin,因为 Claude Mods 对于作用范围做了非常明确并且严格的区块限制。但是我觉得稍有欠缺的地方在于,从设计角度,这种修改本身也应该隔离,也就是说应该为开发者提供一个完全不同的软件引导,从而能够明确的意识到当前的 Agent 是否会修改软件本身的行为。这种情况下,软件本身的主 Agent 是无论如何都不应该去修改软件本身的行为,也就是软件本身不在主 Agent 的作用域内,因为应该为用户提供明确的行为预期。当用户作为开发者,需要去修改行为时,应该明确加载另一个部分进入另外的 Agent 配置,这个 Agent 的作用域也应该约束在软件本身,不能拓展到其他范围。
或许这样可能觉得稍显繁琐,违背了 Agent 软件自身也只是一个普通软件的设计语言,但是我觉得这个设计语言倒也不用坚持,让用户与开发者对 Agent 行为有一个更高的可靠性与可预测性我认为是更重要的,所以 Agent 的作用域范围应该显式的做出区分。
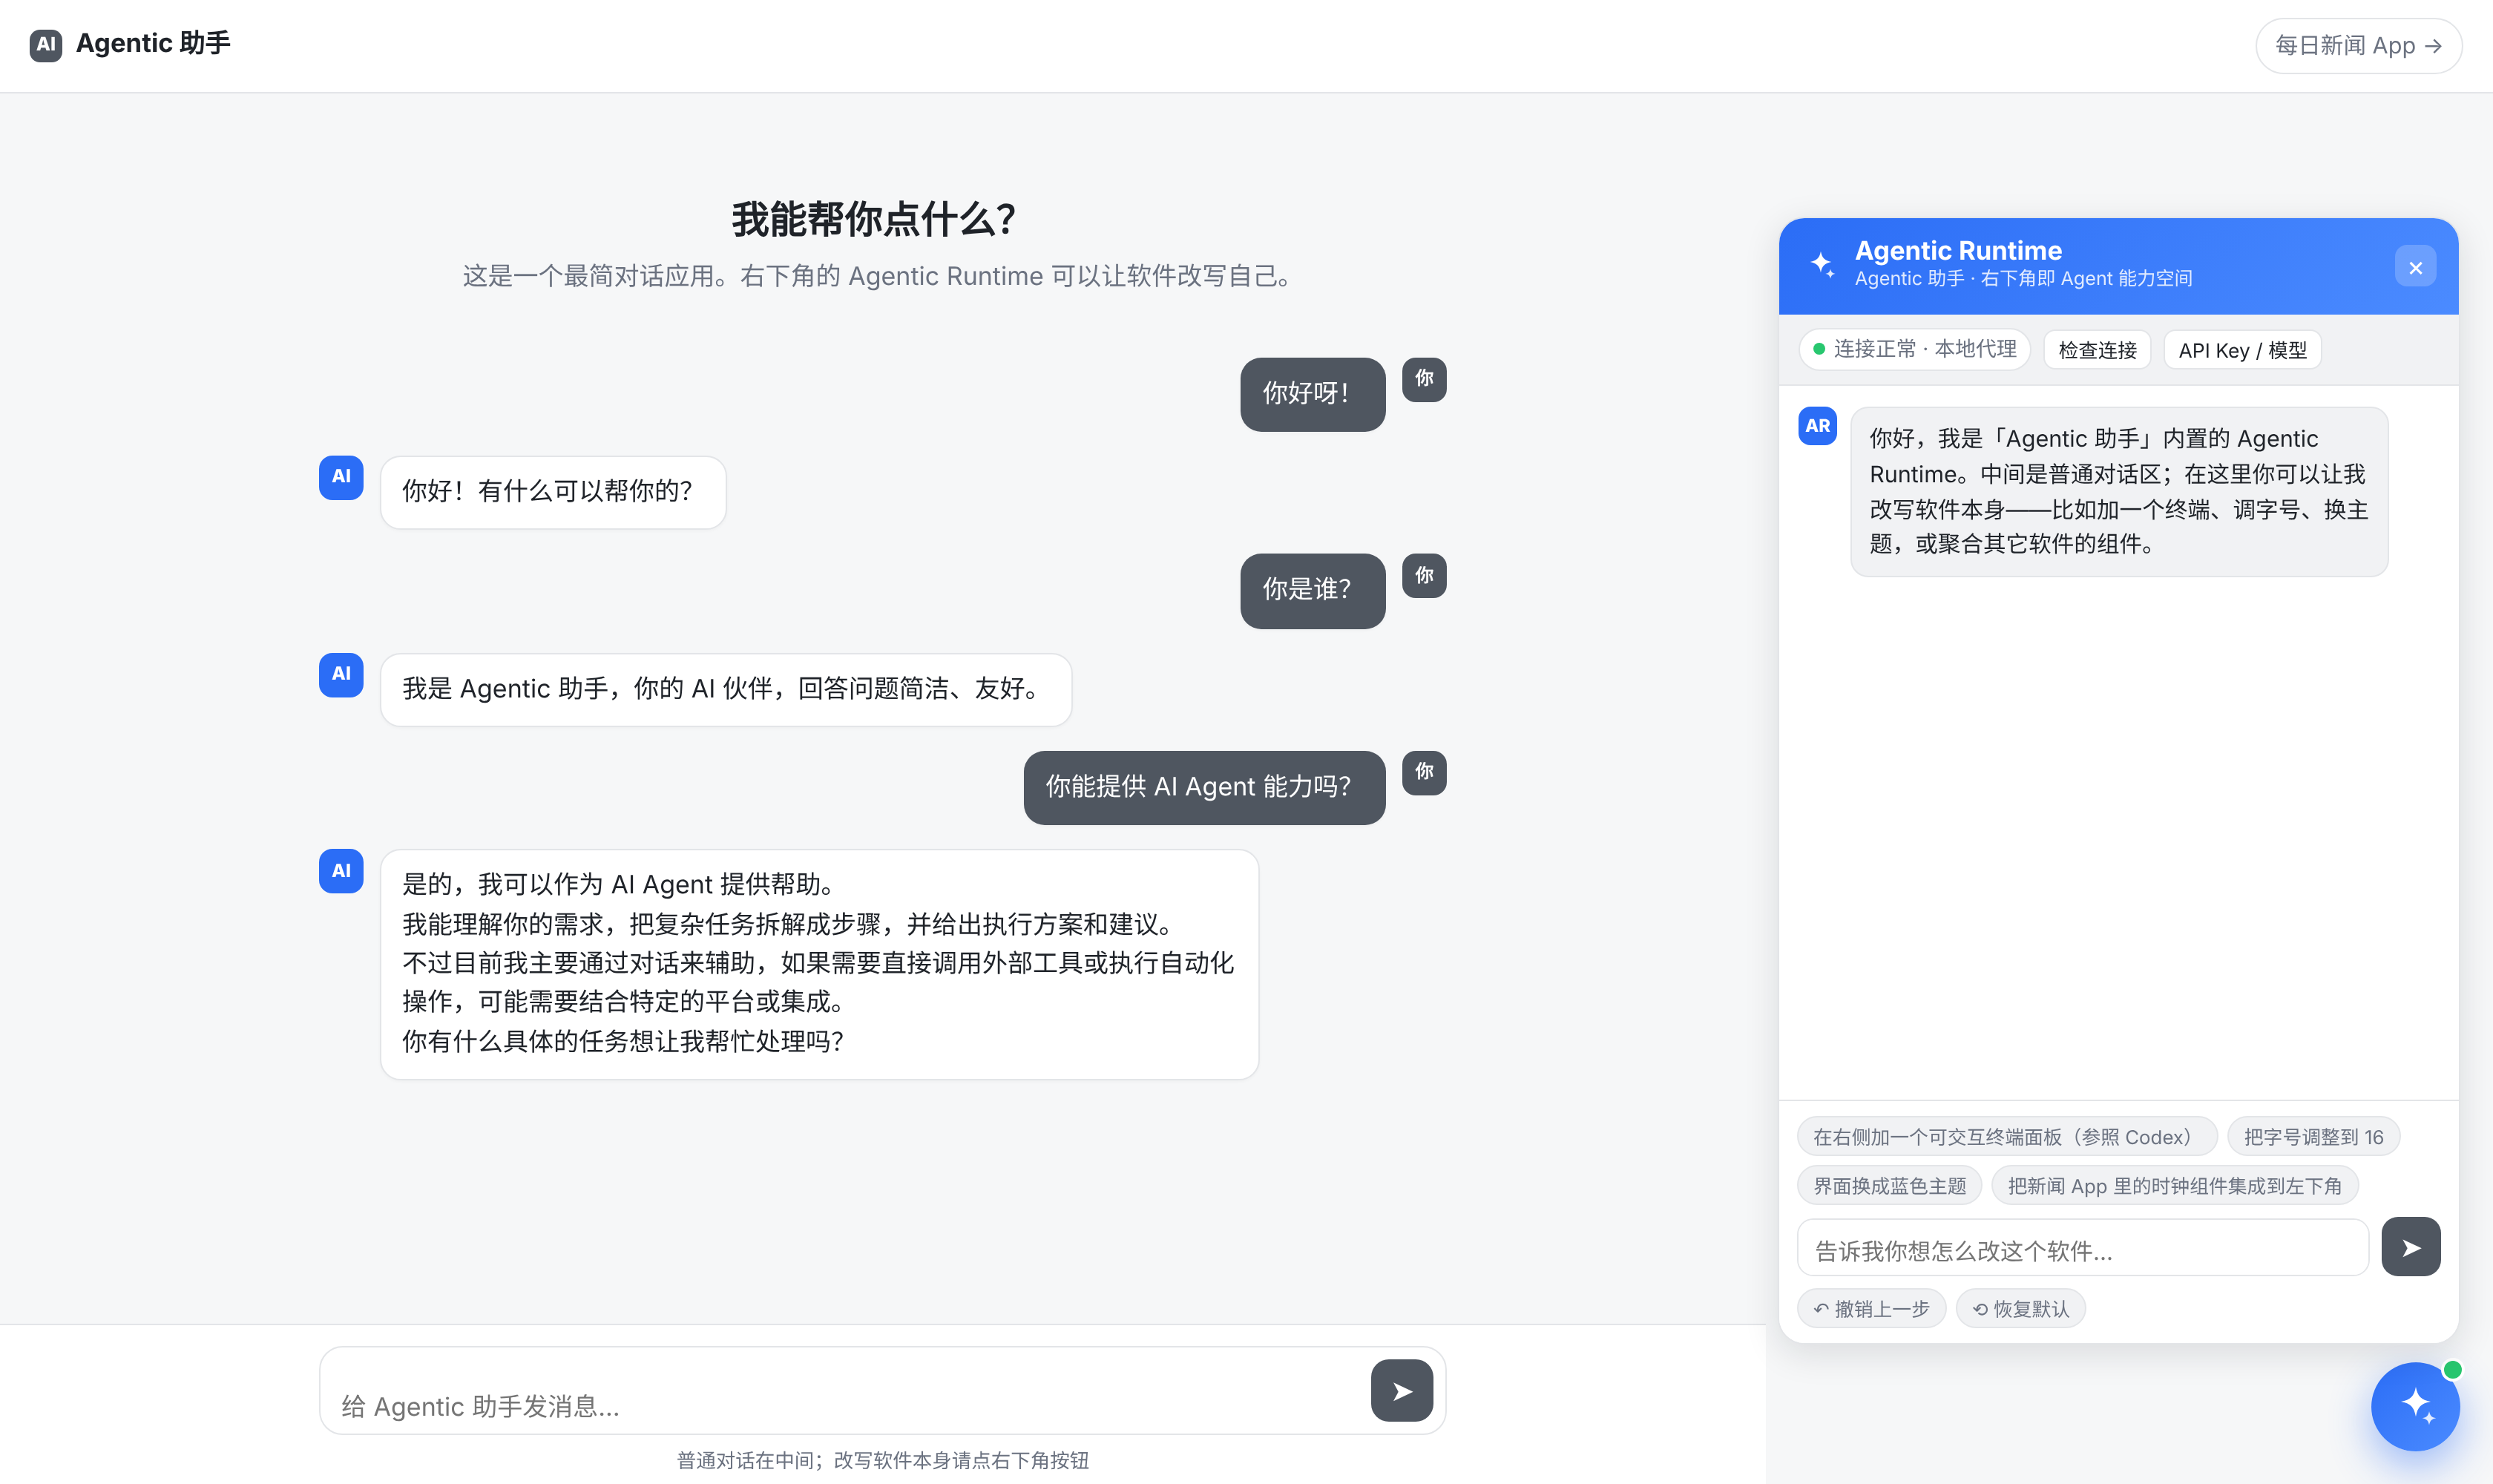
当然,实际做起来有一个非常简单的解决方案,在上半年我做了一个 Demo 用于 Job Talk,就展示了这个解决方案,只需要在右下角做一个明显的隔离区块就行(其实就是一个简易的开发模式),只有右下角的区块的 Agent 才能作用到 Agent Application 自身,从而完全隔离开发者对于 Agent 行为的作用域与预期。
五、最后给开发者的简单配方
把这些发布放在一起,可以得出一个配方:
- 选一个你熟悉的领域。
- 把智能体放进应用里,而不是放在旁边。
- 用统一登录让用户自带套餐,这样推理成本不会拖住你。
- 把应用的事件开放为钩子(hooks),让用户和他们的智能体可以扩展它。
- 保留一条智能体无法改写的权限边界。
- 提供清晰的工具,让未来的个人智能体可以直接与你的应用协作。
结语:先打好地基
Dots 让我们提前看到了未来。总有一天,大多数人会拥有一个了解自己、为自己工作、并能注意到自己遗漏之处的智能体。但是在目前,可能拓展 Agentic AI 的边界更加重要,个人智能体能做的很有限。它需要能听懂它的语言、能安全共享身份、能按需成长的应用。
这就是我们眼前的工作。个人智能体是长期愿景,自主软件是通往那里的一步。
参考资料
- OpenAI launches dots, always-on ChatGPT agents with their own computers — BetaNews
- Everything OpenAI announced at DevDay 2026 — BGR
- DevDay 2026 announcements and developer resources — OpenAI Developer Community
- OpenAI DevDay 2026 live blog — Simon Willison
- Sign in with ChatGPT — OpenAI Developers
- Using your ChatGPT plan in other apps and sites — OpenAI Help Center
- AI Agents News: October 2026 agent releases — Orthotropy
- Personal AI agents are coming to work — Aembit
- Claude Code 2.1.287 adds mods — Mixed
- Anthropic's mods let you change Claude Code's look and behavior — daily.dev
- Claude Mods: setup, function hooks and security — Wavect
写于并发布于 2026 年 10 月 4 日。产品信息以 OpenAI DevDay 2026 与 Claude Code 2.1.287 发布当周的报道为准。三层架构图由 Claude 绘制,截图来自我的 Agentic Runtime Demo。英文版由 Claude 协助从中文原文翻译,再由我审阅。